胜率很容易读懂,也很容易被过度解读。报告一旦写上“50%”,这个数字就可能让人觉得像是某种方法的固定属性,仿佛它的名称或周期一样。实际上,它只是一个特定样本的摘要:被标记为盈利的结果数,除以被计入的总数。即使底层决策没有变化,只要改变哪些记录进入分母的规则,胜率也可能随之变化。
因此,这个百分比需要配上一个问题:哪些情况被计入了?什么才算盈利?这些观察是否可以比较?胜率是根据一份记录得到的估计,不是永久属性,也不是预测。它是否有用,取决于背后的数据和假设。
你统计的是什么事件?
计算简单胜率时,每条观察会被分成两类:盈利或非盈利。如果 80 个符合条件的结果中有 37 个符合既定盈利定义,那么样本胜率就是 37 除以 80,即 46.25%。算术很简单,困难的是确定一条观察是什么,以及盈利边界在哪里。已平仓交易、扣除费用后的持仓结果、一个决策窗口和一笔完整的往返交易,是不同的计量单位。混在一起时必须说明。
“盈利”也需要有规则。它是费用前还是费用后的正收益?不赚不亏的交易算第三类,还是归到非盈利?分批平仓如何合并?这些定义未必有一种适用于所有复盘的标准答案。关键是把规则写下来并始终如一地执行。否则,两个人可以从同一本账本算出不同的胜率,却都正确地完成了除法。
这个定义把连续结果转换成二元分类。当问题关注发生频率时,这种简化很有用,但它会丢掉每次盈亏的大小。它也意味着,分类规则稍有改变,某些观察就可能跨过边界。没有盈利定义的胜率缺少了一部分含义。
相同的百分比,精确度可能不同
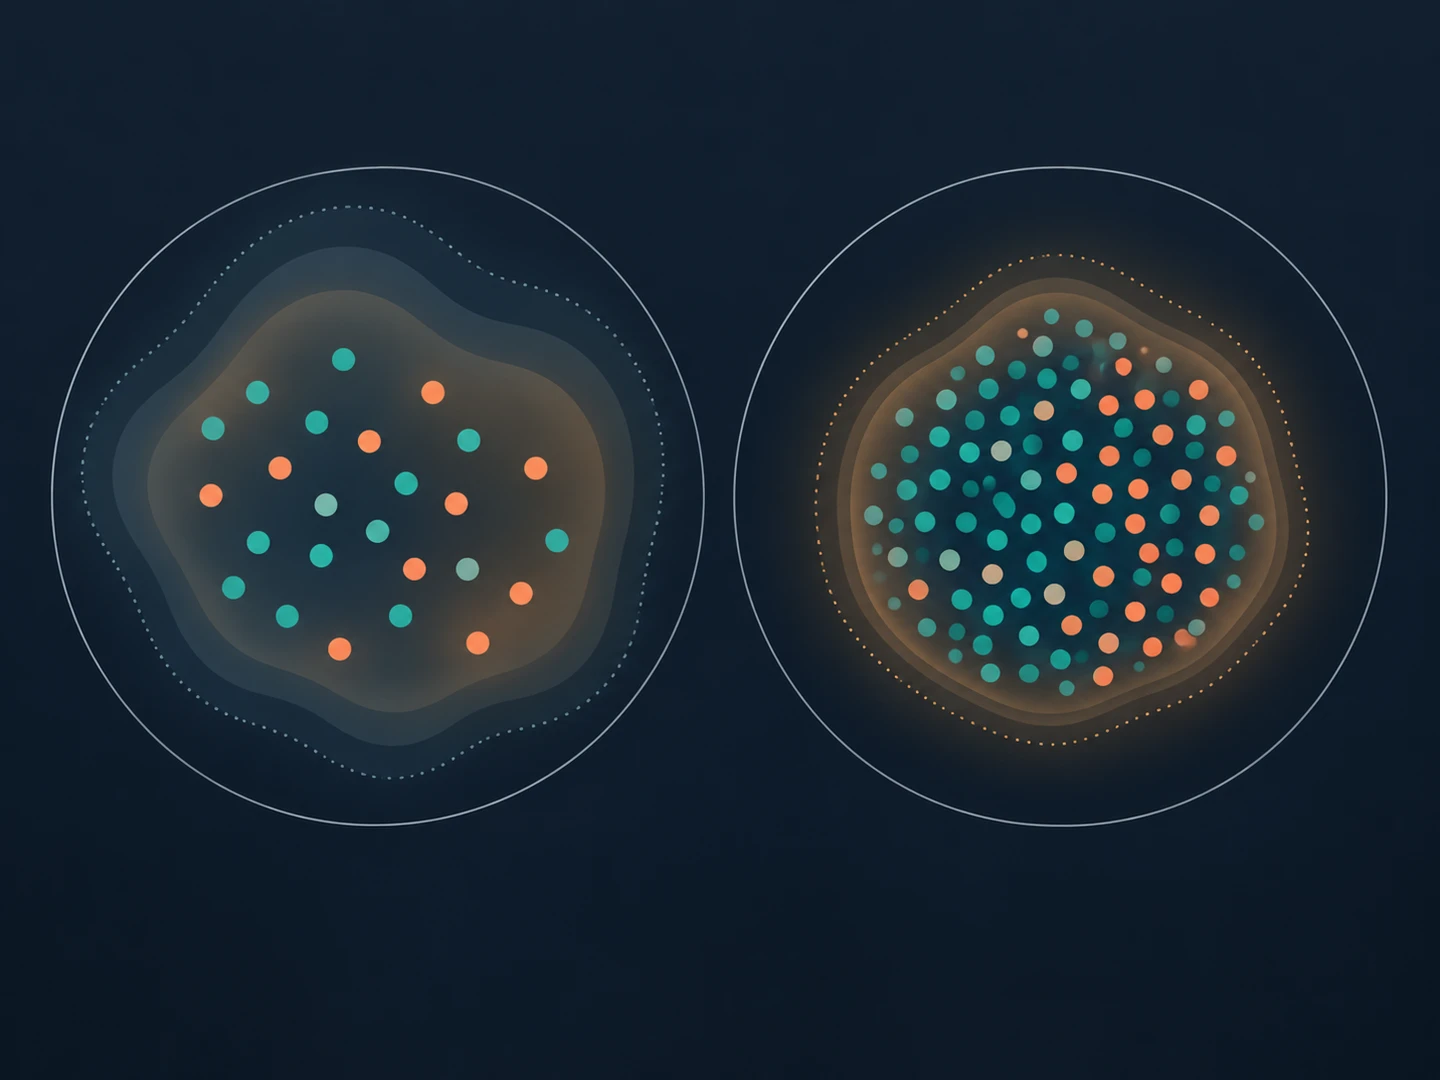
看两个明确标注为假设的记录:一组是 20 次观察中 10 次盈利,另一组是 200 次观察中 100 次盈利。两组的样本胜率都是 50%。第一组并不因此自动错误,第二组也不因此自动具有代表性。但如果底层过程相同且保持稳定,并且各次观察相互独立,较大的样本通常能更精确地估计同一个底层比例。单看百分比看不出这个差别。
置信区间可以让抽样不确定性更直观。它根据观察到的比例,按照指定的方法和模型计算出一个范围。这个区间不是未来交易的预测带。它的宽度取决于估计值、观察数量以及选用的计算方法。即使区间很窄,如果样本筛选不当,或模型不适合这份记录,它仍可能造成误解。
置信区间描述的是一种计算程序
“95% 置信区间”常被理解为“真实胜率有 95% 的概率落在这一次算出的上下限内”。这并不是通常的频率学派解释。置信水平描述的是计算程序在长期重复抽样中的表现:如果在模型成立的情况下反复抽取可比样本,并且每次都计算一个区间,大约 95% 的这些区间会包含固定的总体比例。NIST 对置信区间的解释也是基于这种重复抽样。
在胜率问题中,上述解释里的参数是与某个明确定义的总体或过程相关的比例。区间不会给下一笔交易是盈利的概率,也不保证未来一批结果落在它的范围内,更不表示这个过程会保持不变。这些是不同的问题,不能仅靠区间回答。
比例的区间有多种算法。它们可能给出不同结果,尤其是在样本量很小,或观察比例接近 0 或 1 时。NIST 介绍了 Wilson 区间和精确二项区间,并指出在一些小样本情形下,简单的正态近似可能不够准确。报告应写明所用方法,而不是只贴出电子表格默认单元格中来历不明的上下限。
二项模型是一种有用的简化
一个常见起点是把每条观察视为两种结果之一,并假设每次试验的盈利概率相同。这就是 NIST 所介绍的基本二项设定。在这个模型下,观察比例用于估计一个固定的成功概率。该模型把计数和分母转化成清晰的统计问题,因此很有用。
交易记录未必像从同一个稳定过程里反复抽取的结果。结果可能在时间上聚集,受相同条件影响,也可能来自不同版本的规则或不同市场环境。如果观察之间存在依赖,把每一行都当成独立试验,可能会让证据显得比实际更充分。如果不同分组的盈利概率不同,把它们合成一个比例也可能掩盖重要差异,而不是估计一个稳定的胜率。
文件更大,并不能自动解决这些设计问题。某一个狭窄环境里连续记录的 200 条观察,回答的问题可能比一组规模较小、但刻意涵盖多个环境的样本更窄。样本量只说明计入了多少条记录,不说明这些记录是否代表读者以为胜率所回答的问题。
分母决定你回答的问题
用已平仓交易计算胜率,回答的是这些已平仓交易结果如何。它不会自动描述所有机会、所有决策或所有交易时段。如果复盘只纳入实际执行的交易,分母就不包括没有交易的时刻。这可能正是你想衡量的内容,但不能把它误当成所有符合条件的决策的胜率。
筛选规则也会改变结果。排除不完整记录、跳过困难时期,或只把符合事后定义的情况分在一起,都会改变被摘要的样本。应把纳入规则写清楚,包括缺失记录和筛选条件。记录无交易时段的日志有助于区分“没有出现符合条件的决策”和“记录缺失”;可以参阅相关指南《没有交易时,日志该记录什么》。
胜率不包含盈亏幅度
胜率只说明观察结果有多频繁地跨过某个定义好的边界,却不说明跨过了多少。两组假设样本可能有相同的盈利比例,但一组盈利金额很小、亏损金额很大,另一组的盈亏组合则不同。仅看正负号的计数无法区分它们。均值、中位数、离散程度和回撤回答的是不同问题;关于平均值和中位数的文章解释了为什么单一的中心统计量同样需要背景。
因此,不应把胜率当作独立的评分或目标。样本胜率较高,本身不能证明表现更好、过程更可靠,或未来结果更有利。它只是对一组明确定义的观察中某个特征的描述。
报告胜率时,同时交代它的边界
一份有用的报告应提供足够细节,让读者能够还原这项结论。解释百分比前,先记录:
- 观察单位以及盈利的准确分类规则,包括费用、不赚不亏、分批平仓和未平仓结果如何处理。
- 盈利次数和总分母,并与百分比同时展示,而不是只给百分比。
- 日期、分组、规则版本、排除项、缺失记录,以及任何决定哪些观察进入样本的筛选。
- 如果报告区间,注明区间方法和置信水平,以及解释它时需要注意的假设。
- 把盈亏幅度或回撤等其他指标与胜率分开,因为它们回答的是不同问题,不应混成一个结论。
一种谨慎的写法可以是:“在这组假设样本中,纳入的 200 条观察有 100 条符合既定的盈利定义;报告的区间采用二项方法,并假设各次试验具有共同的成功概率。”这句话不如“胜率是 50%”简洁,但它把统计数字和分母、模型连在了一起。
真正有用的问题,不是孤立地判断胜率看起来高还是低,而是问清楚计入了什么、这些情况为什么属于同一组,以及哪些假设把计数转化成估计。历史或模拟百分比描述的是它所对应的记录,不承诺下一组样本会包含什么。
参考资料与延伸阅读
- Binomial DistributionNIST/SEMATECH e-Handbook of Statistical Methods
- Confidence intervalsNIST/SEMATECH e-Handbook of Statistical Methods
- What are confidence intervals?NIST/SEMATECH e-Handbook of Statistical Methods