Un backtest puede usar la fórmula correcta y aun así responder una pregunta imposible. El sesgo de anticipación aparece cuando una prueba utiliza información que no estaba disponible en el momento simulado de decisión. A veces el error es evidente, como usar sin querer el cierre de una vela antes de que termine. Otras veces se oculta en marcas de publicación, revisiones de datos, etiquetas de conjuntos, ajustes de parámetros o decisiones humanas tomadas después de ver el periodo evaluado.
El problema no es que la información sea necesariamente falsa. Puede ser precisa y, aun así, estar fechada con el concepto equivocado de tiempo. Una cifra económica, una etiqueta corporativa o un valor calculado solo puede participar en una decisión cuando se conocían tanto su contenido como su disponibilidad. Por eso, la pregunta práctica no es únicamente «¿cuál es el valor?», sino «¿cuándo podía saberlo el proceso?».
¿Cuándo está disponible la información para un backtest?
Un registro puede incluir la fecha a la que corresponde un hecho y otra fecha en la que ese hecho se publicó o se pudo obtener. Por ejemplo, una estadística puede describir un periodo que termina el lunes y hacerse pública el jueves. Un backtest que la asigne al lunes sin modelar su publicación puede permitir que el proceso actúe antes de conocerla.
El problema también aparece con revisiones. Los datos macroeconómicos, índices, fundamentales empresariales y conjuntos de referencia pueden corregirse después. Si una reconstrucción histórica sustituye silenciosamente el valor disponible entonces por la versión final actual, la prueba puede usar una visión que los participantes de aquel momento no tenían. Conserva, cuando sea posible, tanto las fechas de publicación como el historial de revisiones.
Traza cada entrada hasta su momento de decisión
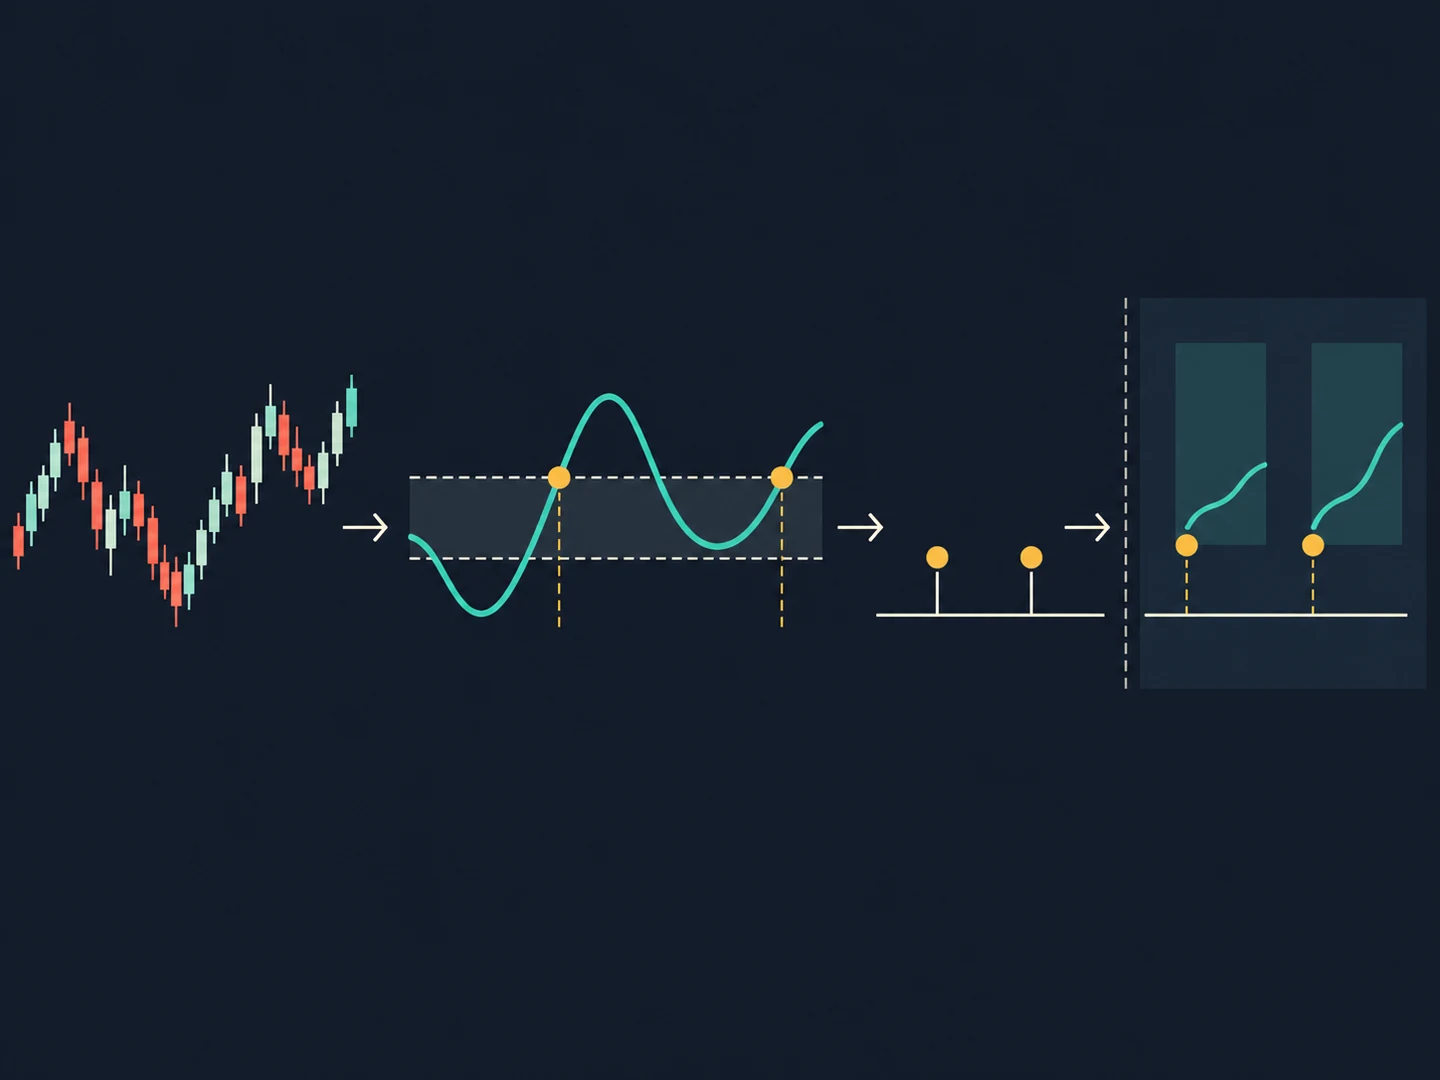
Para cada campo que influya en una clasificación o salida, pregunta qué representa, cuándo se creó, cuándo estuvo disponible y con qué transformaciones llegó al modelo. Un resumen diario puede ocultar la diferencia entre el instante de un evento y el momento en que se confirmó. Un proceso de agregación puede etiquetar una vela por el inicio del periodo aunque su valor de cierre no se conozca hasta el final.
Los documentos de QuantConnect sobre datos personalizados recomiendan modelar la disponibilidad para evitar filtrar información futura. La enseñanza general es mantener separado el tiempo del dato y el tiempo de la decisión, y probar que la canalización no hace visible un valor demasiado pronto. Aunque la fuente sea distinta, el principio de datos puntuales en el tiempo sigue siendo aplicable.
- Tiempo del evento: ¿cuándo sucedió o qué periodo describe el dato?
- Tiempo de publicación: ¿cuándo se conoció por primera vez y cuál es la evidencia?
- Tiempo de revisión: ¿se modificó después, y qué versión estaba disponible entonces?
- Transformación: ¿qué ventanas, agregaciones o etiquetas desplazan su disponibilidad?
- Tiempo de decisión: ¿qué sabía el proceso en el instante exacto simulado?
Evita la fuga al construir etiquetas y características
Una fuga puede entrar durante el diseño de etiquetas, no solo por un dato mal fechado. Imagina una etiqueta cuyo valor depende del recorrido posterior del precio. Esa etiqueta puede ser apropiada como resultado a predecir, pero no debe aparecer entre las entradas del mismo instante. Los límites entre variables predictoras y resultados deben aplicarse de manera coherente en el entrenamiento, la validación y la inferencia simulada.
Las ventanas solapadas también importan. Si una etiqueta usa observaciones futuras que se cruzan con la ventana de validación, las muestras pueden compartir información de resultados aunque estén en lados distintos de una división cronológica. La división por fecha ayuda, pero no siempre basta. La ventana de etiqueta, el tiempo de embargo y cualquier periodo de purga deben reflejar el horizonte que se estudia.
La selección de modelos puede mirar hacia delante
Un proceso de investigación puede filtrar el futuro incluso si la canalización de datos es causal. Si quien investiga prueba muchas combinaciones en el historial completo, escoge una que parece mejor y luego informa del mismo periodo como prueba, el resultado ya se benefició de información procedente de ese periodo. La selección se convierte en un canal de anticipación.
Los datos no se conocen solo mediante columnas. También los revela una persona que revisa cientos de gráficos, cambia un umbral tras ver el resultado o conserva únicamente configuraciones que sobrevivieron al periodo evaluado. Registra el historial de experimentos y distingue entre material de desarrollo y un conjunto reservado. La documentación de optimización de QuantConnect también advierte sobre el sobreajuste y el sesgo de anticipación durante la búsqueda de parámetros.
Un conjunto reservado no es una solución permanente si se consulta una y otra vez. Cada revisión puede convertirlo en parte del proceso de desarrollo. Mantén un registro de cuántas decisiones de investigación dependen de cada periodo, describe cuándo se modificó el método y, cuando sea posible, evalúa una especificación congelada en un tramo que aún no se haya utilizado para elegirla.
Alinea las decisiones con la información disponible
Para cada decisión simulada, crea una instantánea de las entradas conocidas en ese momento. Una prueba sencilla puede ocultar todas las observaciones posteriores a la marca de tiempo de decisión y volver a calcular las características con lo que quedaba. Si una clasificación anterior cambia cuando se añaden datos futuros, hay una fuga o una convención de disponibilidad mal documentada que investigar.
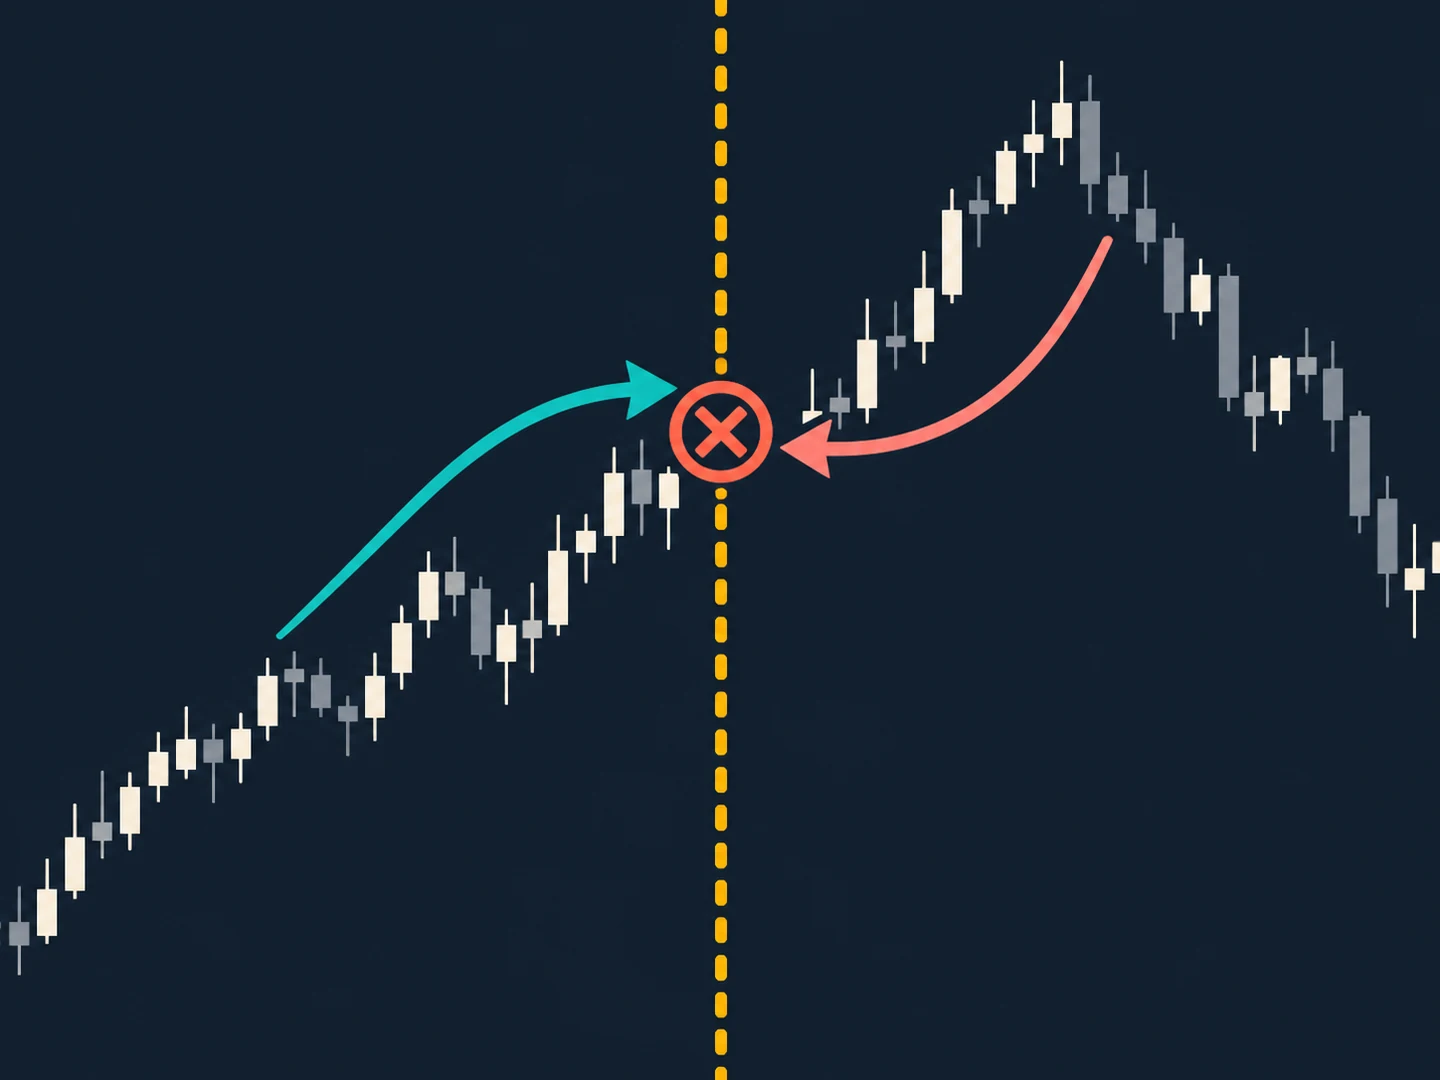
El orden de ejecución también importa. Una condición que usa el cierre de la vela actual no está disponible antes de ese cierre. Si una prueba simula una ejecución en ese mismo cierre, tiene que justificar cómo pudo recibir la información y completar la orden con esa convención. Los gráficos históricos muestran el resultado final; por sí solos no prueban que ese resultado estuviera disponible en el instante supuesto.
Construye pruebas dirigidas a los límites temporales
No dependas únicamente de una rentabilidad resumida para detectar fugas. Añade pruebas unitarias para publicaciones demoradas, datos revisados, valores ausentes, inicialización de ventanas, saltos de sesión y puntos de decisión cercanos a la frontera entre entrenamiento y validación. Usa ejemplos pequeños donde el dato correcto esté disponible en un momento conocido y comprueba que el proceso lo oculta hasta entonces.
- Busca un valor publicado después del periodo que describe y comprueba que no aparezca antes de publicarse.
- Compara la versión de datos disponible entonces con revisiones posteriores.
- Confirma que las etiquetas no vuelvan a entrar accidentalmente como características.
- Inspecciona las ventanas solapadas entre entrenamiento y validación.
- Repite una clasificación pasada ocultando todas las observaciones posteriores.
- Registra cuántas variantes se probaron antes de seleccionar el resultado informado.
Comunica límites y convenciones
Una evaluación histórica transparente documenta la marca de tiempo de decisión, la fuente y convención de disponibilidad, las ventanas de transformación, la división de muestras, el historial de selección del modelo, el momento de ejecución y las limitaciones pendientes. Añade un ejemplo que muestre cómo viaja un valor desde su origen hasta la decisión. Si quien revisa no puede saber qué era conocido en ese instante, el resumen de resultados llega demasiado pronto.
- Separar un indicador de una regla comprobable
- Leer resultados de operaciones más allá de una media
- Abrir una sesión de práctica en replay
Fuentes y lecturas adicionales
- Conceptos clave de datos personalizados: evitar sesgo de anticipaciónDocumentación de QuantConnect
- Parámetros de optimización: sobreajuste y sesgo de anticipaciónDocumentación de QuantConnect