Es fácil leer una tasa de aciertos y también es fácil atribuirle demasiado significado. Cuando un informe muestra «50 %», la cifra puede empezar a parecer una propiedad de un método, casi como su nombre o su marco temporal. En realidad, resume una muestra definida: el número de resultados etiquetados como aciertos dividido por el total contado. Si cambia la regla que determina qué entra en el denominador, puede cambiar la tasa aunque las decisiones subyacentes sean las mismas.
Por eso, el porcentaje necesita una pregunta asociada. ¿Qué casos se contaron? ¿Qué se consideró un acierto? ¿Eran comparables las observaciones? La tasa es una estimación obtenida de un registro, no un rasgo permanente ni un pronóstico. Su utilidad depende de los datos y supuestos que la respaldan.
¿Qué evento estás contando?
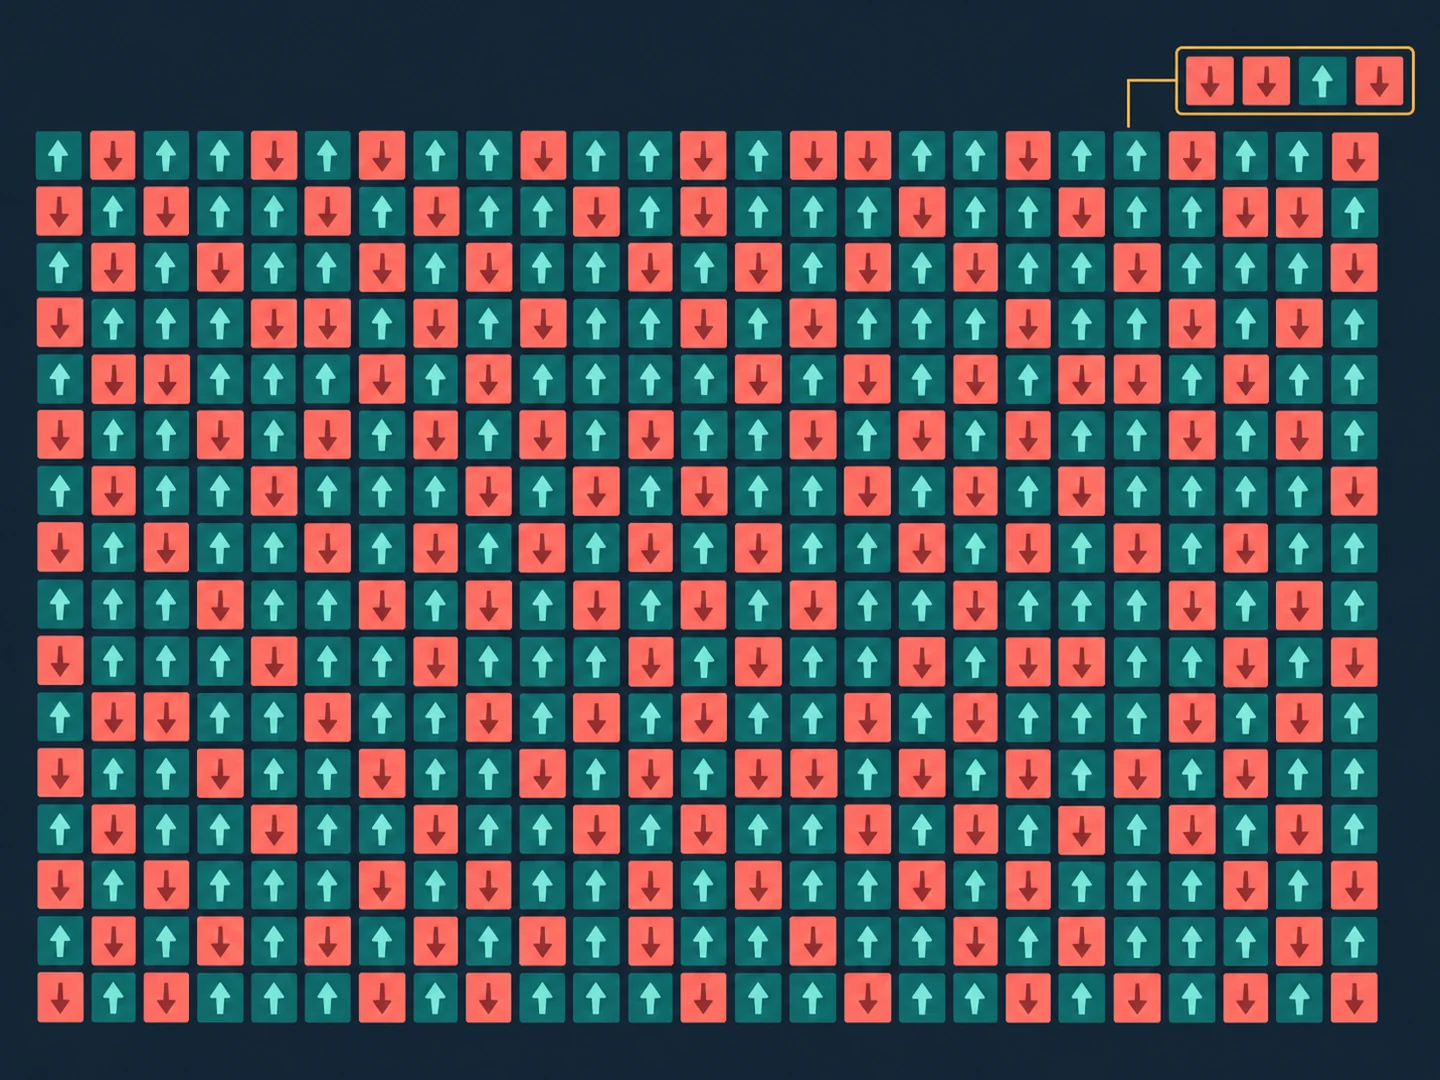
Para calcular una tasa sencilla, cada observación se clasifica en dos grupos: acierto o no acierto. Si 37 de 80 resultados elegibles cumplen la definición acordada, la tasa muestral es 37 dividido entre 80, es decir, 46,25 %. La aritmética es sencilla. Lo difícil es decidir qué constituye una observación y dónde está el límite que separa un acierto. Una operación cerrada, una posición después de costes, una ventana de decisión y una operación completa de ida y vuelta son unidades distintas. No conviene mezclarlas sin explicarlo.
La etiqueta también necesita una regla. ¿Acierto significa un resultado positivo antes o después de costes? ¿Una operación sin ganancia ni pérdida se clasifica aparte o junto a los no aciertos? ¿Cómo se combinan los cierres parciales? No existe una definición universalmente correcta para toda revisión. Lo importante es dejarla por escrito y aplicarla de forma coherente. De lo contrario, dos personas pueden calcular tasas distintas a partir del mismo registro y hacer correctamente la división.
Esta definición convierte un resultado continuo en una clasificación binaria. La simplificación sirve cuando la pregunta trata de frecuencia, pero descarta el tamaño de cada ganancia y pérdida. También implica que un cambio pequeño en la clasificación puede mover observaciones a través del límite. Una tasa sin su regla de clasificación está incompleta.
El mismo porcentaje puede tener distinta precisión
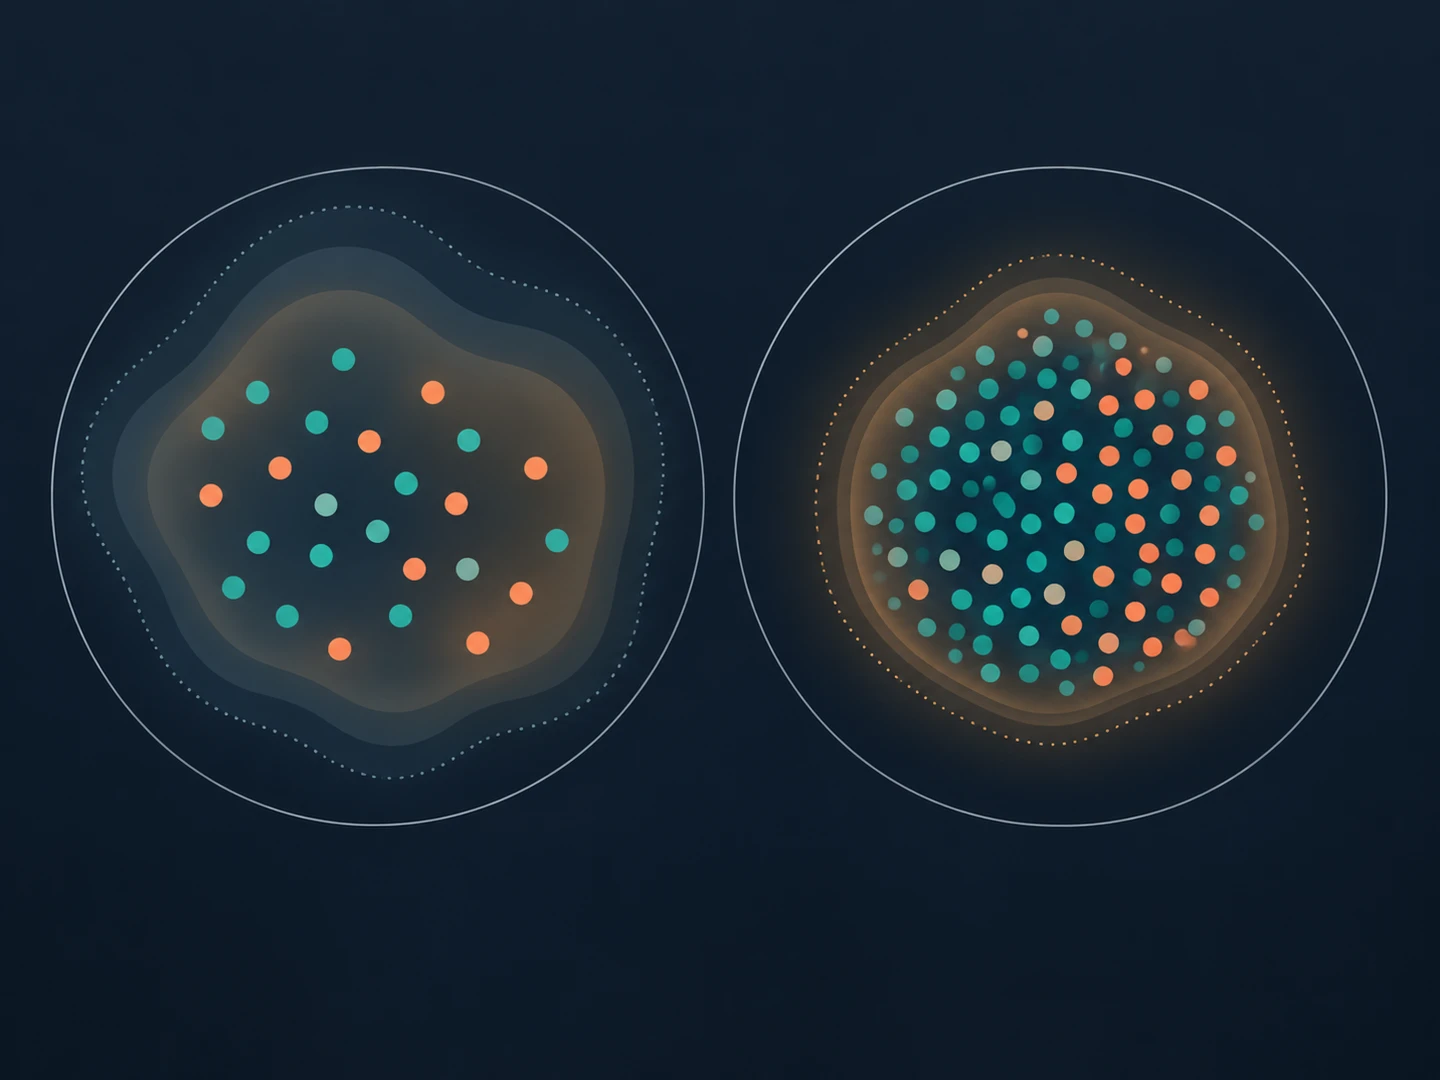
Considera dos registros claramente hipotéticos. Uno contiene 10 aciertos en 20 observaciones; el otro, 100 en 200. Ambos muestran una tasa muestral del 50 %. La primera fracción no es automáticamente incorrecta, y la segunda tampoco es automáticamente representativa. Pero si el proceso subyacente es común, permanece estable y las observaciones son independientes, la muestra mayor suele ofrecer una estimación más precisa de la misma proporción subyacente. El porcentaje por sí solo oculta esa diferencia.
Un intervalo de confianza puede hacer más visible la incertidumbre muestral. Presenta un rango calculado a partir de la proporción observada mediante un método y un modelo determinados. No es una banda de pronóstico para las operaciones futuras. Su amplitud depende de la estimación, del número de observaciones y del procedimiento elegido. Un intervalo estrecho también puede inducir a error si la muestra se seleccionó mal o el modelo no representa los registros.
Un intervalo de confianza describe un procedimiento
La expresión conocida «intervalo de confianza del 95 %» suele interpretarse como «hay un 95 % de probabilidad de que la tasa verdadera esté dentro de estos límites concretos». Esa no es la interpretación frecuentista habitual. El nivel de confianza describe el comportamiento a largo plazo del procedimiento: si se extrajeran repetidamente muestras comparables bajo el modelo y se calculara un intervalo cada vez, alrededor del 95 % de esos intervalos incluiría la proporción fija de la población. NIST explica los intervalos de confianza en estos términos de muestreo repetido.
En una tasa de aciertos, el parámetro de esa explicación es una proporción asociada a una población o proceso definido. El intervalo no asigna una probabilidad a que la próxima operación sea un acierto, no garantiza que un bloque futuro de resultados quede dentro de sus límites ni afirma que el proceso vaya a mantenerse sin cambios. Son preguntas distintas que el intervalo, por sí solo, no responde.
Hay varios métodos para calcular un intervalo de una proporción. Pueden comportarse de forma distinta, en especial con muestras pequeñas o cuando la tasa observada está cerca de cero o de uno. NIST describe los métodos de Wilson y binomial exacto, y advierte que una aproximación normal sencilla puede no ser suficientemente precisa en algunos casos con pocas observaciones. Un informe debería indicar el método, en lugar de mostrar límites inexplicados de una celda predeterminada de una hoja de cálculo.
El modelo binomial es una simplificación útil
Un punto de partida habitual trata cada observación como uno de dos resultados y supone que la probabilidad de acierto es la misma de una prueba a otra. Esa es la configuración binomial básica que describe NIST. Bajo ese modelo, la proporción observada estima una probabilidad fija de éxito. El modelo resulta útil porque convierte un recuento y un denominador en una pregunta estadística clara.
Los registros de trading quizá no se comporten como extracciones repetidas de un proceso único e invariable. Los resultados pueden agruparse en el tiempo, compartir las mismas condiciones o proceder de versiones distintas de las reglas y de entornos de mercado diferentes. Si las observaciones dependen entre sí, contar cada fila como una prueba independiente puede hacer que la evidencia parezca más sólida de lo que es. Si la probabilidad de acierto cambia entre grupos, una sola proporción conjunta puede ocultar diferencias importantes en vez de estimar una tasa estable.
Un archivo más grande no resuelve por sí solo esos problemas de diseño. Doscientas observaciones consecutivas de un único entorno limitado pueden responder una pregunta más estrecha que una muestra menor, pero definida deliberadamente para varios entornos. El tamaño indica cuántos registros se contaron. No indica si representan la pregunta que el lector cree que responde la tasa.
El denominador determina la pregunta
Una tasa calculada sobre operaciones cerradas responde a una pregunta sobre los resultados de esas operaciones cerradas. No describe automáticamente todas las oportunidades, decisiones o sesiones. Si una revisión incluye solo las operaciones ejecutadas, el denominador excluye los momentos en que no hubo ninguna. Puede ser exactamente la medida buscada, pero no debe confundirse con una tasa de todas las decisiones elegibles.
Las reglas de selección también cambian el resultado. Excluir registros incompletos, omitir un período difícil o agrupar solo los casos que encajan con una definición posterior modifica la muestra resumida. Mantén visible el criterio de inclusión, incluidos los datos ausentes y los filtros. Un diario que registra las sesiones sin operaciones puede ayudar a distinguir «no apareció una decisión que cumpliera los criterios» de «falta el registro»; consulta la guía relacionada sobre qué registrar cuando no hubo ninguna operación.
La tasa de aciertos no incluye el tamaño del resultado
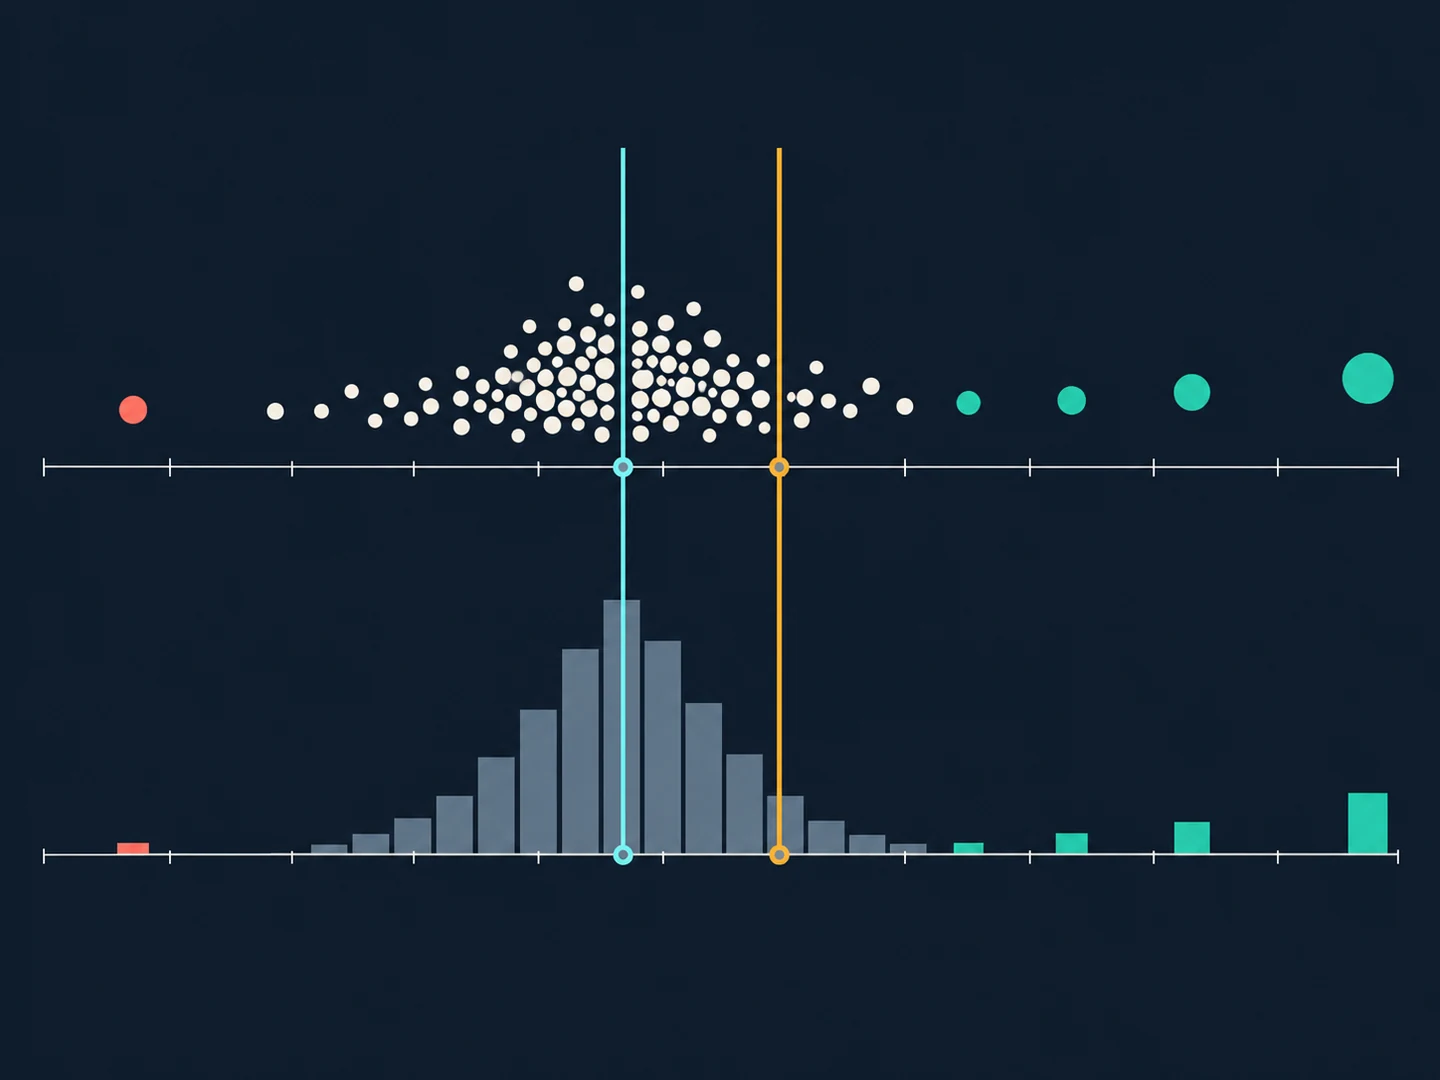
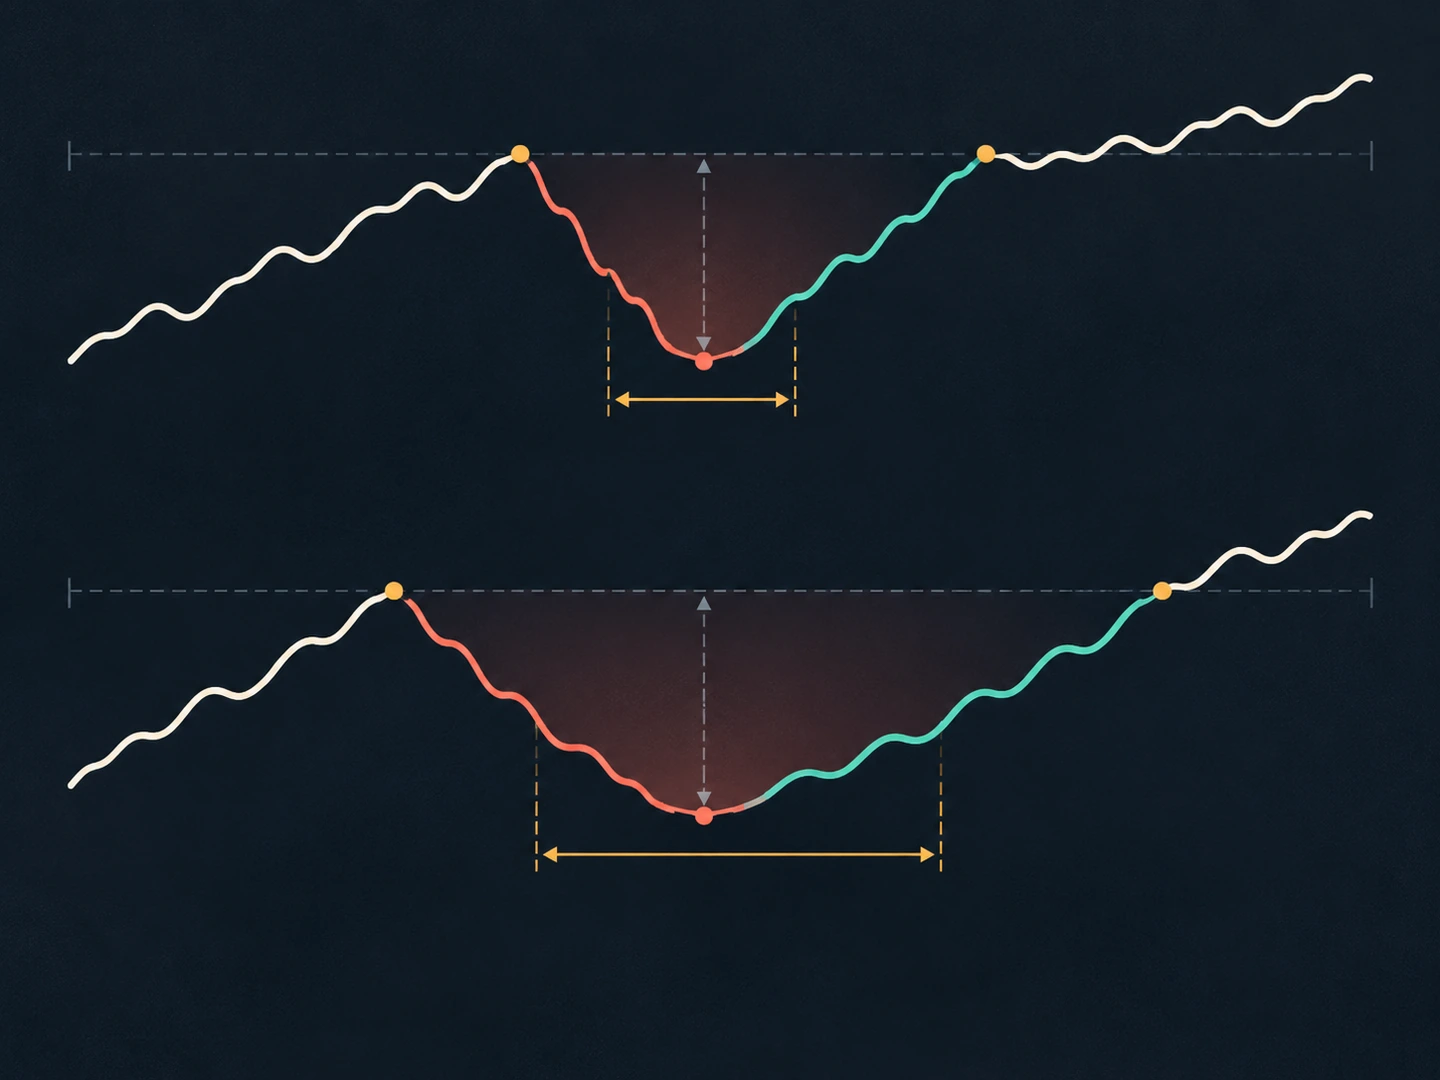
La tasa indica con qué frecuencia las observaciones cruzaron un límite elegido. No dice cuánto lo cruzaron. Dos muestras hipotéticas pueden contener la misma proporción de aciertos, aunque una tenga resultados positivos pequeños y pérdidas negativas grandes, y la otra presente otra combinación de pagos. El recuento de signos no permite distinguirlas. La media, la mediana, la dispersión y el drawdown responden preguntas distintas; nuestra guía sobre resultados medios y medianos explica por qué una sola medida central también necesita contexto.
Por eso, la tasa de aciertos no debería tratarse como una puntuación o un objetivo independiente. Una tasa muestral más alta no demuestra por sí sola un mejor rendimiento, un proceso más fiable ni un resultado futuro favorable. Es una descripción de una característica dentro de un conjunto definido de observaciones.
Informa la estimación junto con sus límites
Un informe útil ofrece detalles suficientes para reconstruir la afirmación. Antes de interpretar el porcentaje, registra:
- La unidad de observación y la regla exacta para clasificar un acierto, incluidos los costes, los resultados neutros, los cierres parciales y las posiciones abiertas.
- El recuento de aciertos y el denominador total junto al porcentaje, no el porcentaje por sí solo.
- Las fechas, los grupos, las versiones de las reglas, las exclusiones, los registros ausentes y cualquier decisión que determinara qué observaciones entraron en la muestra.
- El método del intervalo y el nivel de confianza, si se informa uno, además de los supuestos relevantes para interpretarlo.
- Otras medidas que responden preguntas distintas, como el tamaño de los resultados o el drawdown, separadas de la tasa en lugar de fundirlas en un único veredicto.
Una frase cuidadosa podría decir: «En esta muestra hipotética, 100 de 200 observaciones incluidas cumplen la definición de acierto indicada; el intervalo informado usa un método binomial que supone una probabilidad de éxito común entre las pruebas». Es menos elegante que «la tasa es del 50 %», pero mantiene la estadística ligada a su denominador y a su modelo.
La pregunta útil no es si una tasa de aciertos parece alta o baja de forma aislada. Pregunta qué se contó, por qué los casos pertenecen al mismo grupo y qué supuestos convierten el recuento en una estimación. Un porcentaje histórico o simulado describe su registro. No promete lo que contendrá una muestra posterior.
- Qué revelan la media y la mediana de los resultados
- Por qué una racha corta puede inducir a error
- Compara la profundidad y duración del drawdown
Fuentes y lecturas adicionales
- Binomial DistributionNIST/SEMATECH e-Handbook of Statistical Methods
- Confidence intervalsNIST/SEMATECH e-Handbook of Statistical Methods
- What are confidence intervals?NIST/SEMATECH e-Handbook of Statistical Methods